Architecture CQRS
Introduction
Une application ne traite pas toujours ses données de la même façon lorsqu’elle les modifie et lorsqu’elle les affiche. Pour valider une commande, elle doit faire respecter des règles métier. Pour présenter cette commande, elle peut avoir besoin d'informations propres à la commande, d’une liste d'articles, d’un montant total et du montant de la TVA, etc.
L'architecture CQRS propose de séparer les modèles et les traitements utilisés pour consulter les données de ceux utilisés pour les modifier. Cette architecture logicielle n’impose pas de séparer les applications (une application pour la lecture ; une autre pour l'écriture) ni les bases de données. Les traitements de lecture et d’écriture peuvent appartenir à une même application et accéder aux mêmes tables, tout en utilisant des modèles distincts. Une mise en œuvre plus avancée peut utiliser des bases séparées : il faut alors organiser la mise à jour des données destinées à la lecture.
Présentation
Le sigle CQRS signifie Command Query Responsibility Segregation, soit la séparation des responsabilités entre commandes et requêtes :
- Une commande demande un changement d’état : créer une commande client, modifier une adresse ou annuler une réservation. Son traitement vérifie les règles métier, effectue la modification et renvoie un résultat adapté.
- Une requête consulte des données sans modifier l’état métier de l'application. Elle renvoie une réponse adaptée à un composant d'affichage ou tout autre composant qui en a besoin.
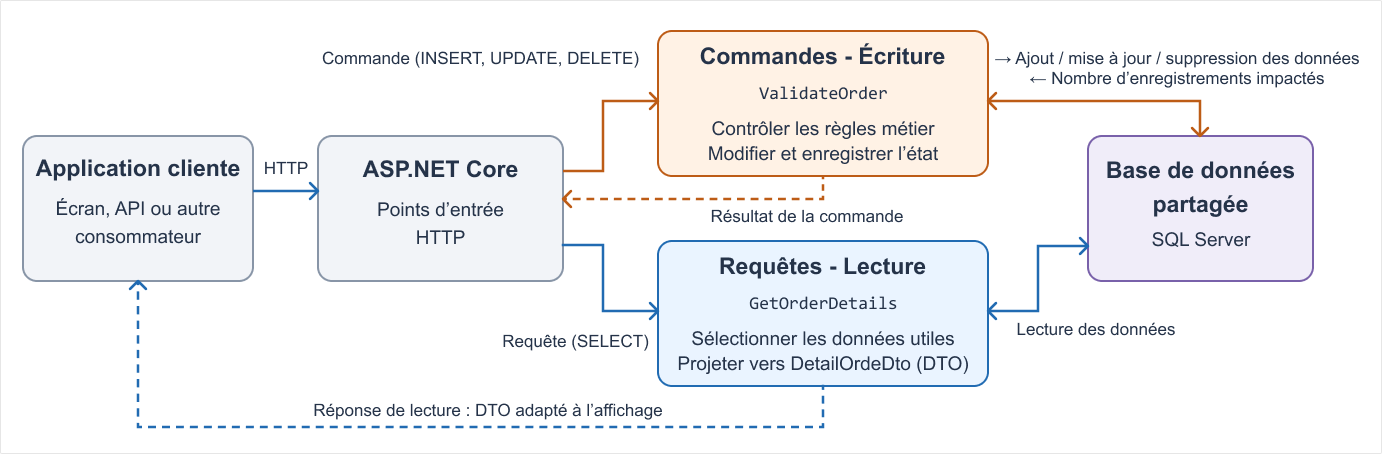
Les lectures et les écritures répondent à des besoins différents. Le modèle de lecture est conçu pour restituer efficacement les informations demandées ; le modèle d’écriture porte les règles métier et préserve la cohérence des modifications.
Un simple exemple en C#
Dans une application de commandes, le record ValidateOrder représente une commande : son traitement vérifie que la commande peut encore être validée, puis applique la validation. Le record GetOrderDetails représente une requête : son traitement consulte les données et retourne un OrderDetailsDto contenant l’identifiant, le numéro et le montant total de la commande. Il n’est pas nécessaire de retourner directement l’agrégat utilisé pour appliquer les règles métier.
Dans ASP.NET Core, un point d’entrée reçoit une demande puis appelle le traitement correspondant. Une commande peut charger des entités avec EF Core, appliquer une opération métier et enregistrer les changements. Une requête peut projeter directement les données nécessaires dans un DTO, avec EF Core, ADO.NET ou un autre outil d’accès aux données selon le besoin.
public sealed record GetOrderDetails(long OrderId);

public sealed record ValidateOrder(long OrderId);

// DTO pour la lecture des données.
public sealed record OrderDetailsDto(
    long Id,
    string Number,
    decimal TotalAmount
);
Ces types expriment des intentions différentes. ValidateOrder demande la validation d’une commande ; GetOrderDetails demande ses informations détaillées ; OrderDetailsDto contient les informations retournées. En pratique, chaque commande et chaque requête possède un traitement dédié.
Les avantages
Des responsabilités plus lisibles
Les traitements qui modifient l’état sont séparés de ceux qui consultent les données.
Des lectures adaptées aux cas d'utilisation
Chaque requête peut retourner les données nécessaires à un écran sans exposer tout le modèle d’écriture.
Des règles métier mieux protégées
Les traitements des commandes permettent d'appliquer les règles métier.
Des optimisations ciblées
La séparation permet d’optimiser les traitements de lecture et d’écriture selon leurs besoins respectifs. Avec des stockages distincts, leurs structures de données peuvent également être optimisées séparément.
Les limites
Les limites dépendent du degré de séparation choisi : une séparation dans le code ajoute surtout des éléments à organiser, tandis que des modèles de lecture matérialisés (structuration des données préparée et stockée pour faciliter les lectures) ou des stockages distincts introduisent des contraintes supplémentaires de synchronisation et d’exploitation.
Plus de code à organiser
Des commandes, requêtes, traitements et DTO distincts peuvent alourdir une application CRUD très simple.
Une synchronisation à gérer
Lorsque le modèle de lecture est mis à jour de manière asynchrone, il peut présenter temporairement des données anciennes.
Une exploitation plus complexe
Des modèles de lecture matérialisés ajoutent des traitements à surveiller, reconstruire et faire évoluer.
Quand cette architecture est-elle un choix pertinent ?
L’architecture CQRS est pertinente lorsque les opérations de lecture et d’écriture répondent à des besoins différents. Elle peut notamment être utile dans les cas suivants :
- Les modifications impliquent des règles métier complexes : valider une commande, autoriser un paiement ou annuler une réservation nécessite de vérifier des conditions et de préserver la cohérence des données.
- Les lectures demandent des représentations spécifiques : un formulaire de détail, un tableau de bord et un rapport peuvent avoir besoin de données différentes, regroupées dans des DTO adaptés.
- Les volumes de lecture et d’écriture sont très différents : une application peut recevoir beaucoup de consultations et peu de modifications. Séparer les traitements permet de les optimiser selon leurs besoins respectifs.
- Certaines lectures nécessitent des optimisations particulières : des modèles de lecture précalculés ou dénormalisés peuvent éviter des jointures et des calculs coûteux à chaque consultation.
- Les besoins évoluent indépendamment : de nouveaux écrans ou rapports peuvent être ajoutés sans modifier le modèle utilisé pour appliquer les règles métier.
Pour une application essentiellement CRUD, dont les opérations sont simples et utilisent des représentations similaires, CQRS peut ajouter une complexité peu justifiée. Il est possible de commencer par séparer les traitements de lecture et d’écriture dans le code, tout en conservant une base de données commune.
Bonnes pratiques avec .NET
Commencer par les cas d’utilisation
Nommer les commandes selon les actions métier et les requêtes selon les informations attendues.
Projeter les lectures de données dans des DTO
Sélectionner les données utiles à la réponse, sans charger systématiquement toutes les entités du domaine.
Vérifier les règles métier avant les ajouts, modifications et suppressions
Appliquer les règles métier dans le traitement des commandes et protéger la cohérence des données à l’aide de transactions et de contraintes de base de données.