Architecture distribuée
Introduction
Une application s'exécutant dans un seul processus, peut avoir besoin d'échanger avec d’autres applications. Dès que son fonctionnement dépend de composants qui communiquent sur un réseau, la vision de l’architecture change. La consommation d'un service distant peut mettre plus de temps que prévu, ou alors un service peut être indisponible pendant un durée indéterminée.
L’architecture distribuée permet de répartir des responsabilités et des traitements. Elle apporte de la souplesse dans certains contextes, au prix de nouvelles contraintes de conception et d’exploitation.
Présentation
Une architecture distribuée est un système composé de plusieurs applications qui s’exécutent sur des machines distinctes, dans des conteneurs distincts ou dans des processus distincts sur une même machine. Elles s'offrent des services dans leur périmètre métier respectif basés sur des échanges sur un réseau réseau.
Par exemple, une application de vente peut exposer un service Web API chargé de traiter les commandes, de traiter des mails et accéder à une base de données. Une commande reçue par l’API peut être enregistrée, qui pourra lever un évènement avertissant d'autres applications de la présence de cette commande, au travers d'un service de notification.
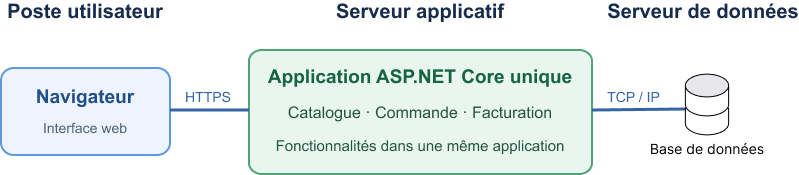
Distribué ne veut pas nécessairement dire « microservices ». Une architecture orientée services, une application Web associée à des workers et à une messagerie, ou un système de microservices sont tous des systèmes distribués. La taille des composants, leur autonomie et la propriété de leurs données varient selon l’architecture choisie. Un monolithe peut lui-même participer à un système distribué lorsqu’il échange avec des services externes. Les différents éléments collaborent suivant différents aspects :
- Échanges synchrones : HTTP/REST ou gRPC lorsque l’application appelante a besoin d’une réponse pour poursuivre son traitement. Elle dépend alors de la disponibilité et du temps de réponse de l’autre application.
- Échanges asynchrones : messages ou événements lorsque le traitement peut être différé. Une file peut absorber un pic de charge et découpler l’émetteur du consommateur, mais il est nécessaire de gérer le suivi des messages, les doublons et les erreurs.
- Données : les périmètres métier déterminent qui peut écrire quelles données. Si plusieurs services modifient directement les mêmes tables d'une base de données, il peut être difficile de gérer les accès concurrents. Selon les besoins, on peut exposer les données et leur gestion au travers d'une API.
Le choix entre ces modes dépend du besoin métier : réponse immédiate, délai acceptable, volume des données traitées, garanties de livraison et cohérence attendue entre les services.
Les avantages
Gestion des ressources ciblée
Les composants les plus sollicités peuvent recevoir davantage de ressources sans augmenter systématiquement celles de toute l’application.
Des déploiements indépendants
Des composants isolés peuvent évoluer et être publiés séparément, si leurs contrats restent compatibles.
Une meilleure isolation de certains incidents
La défaillance d’un composant peut être contenue lorsque des mécanismes de repli ont été prévus.
Une répartition claire des responsabilités
Des périmètres métier cohérents permettent d’affecter à chaque application un périmètre précis.
Une intégration facilitée
Des API et des événements explicites permettent aux applications de collaborer, et d'avoir des traitements qui évoluent à des rythmes de mises à jour différents.
Ces avantages ne sont pas automatiques : ils dépendent du découpage, des contrats et de la capacité à exploiter le système sur lesquelles les applications s'exécutent.
Les limites
Des échanges réseau incertains
Chaque appel ajoute de la latence et peut parfois échouer ou expirer (*timeout*), même lorsque les deux composants fonctionnent de manière attendue.
Une cohérence des données plus complexe
Une opération répartie entre plusieurs services ne bénéficie pas d’une transaction unique.
Un diagnostic plus difficile
Une opération traverse plusieurs processus : sans traces corrélées par un identifiant unique et des journaux structurés, retrouver la cause d’une anomalie peut être chronophage.
Un coût d’exploitation supérieur
Déploiements, sécurité, supervision, communication et infrastructure multiplient les éléments à configurer et à maintenir.
Des contrats d'API à versionner
Une modification d’API ou de message peut perturber des consommateurs encore déployés avec une version antérieure, nécessitant de versionner les API.
Des tests plus exigeants
Les tests unitaires locaux ne suffisent pas à couvrir les délais d'exécution, les incidents, les doublons et les interactions entre applications.
Quand cette architecture est-elle un choix pertinent ?
Elle devient intéressante lorsque la séparation des composants répond à un besoin concret, tel que :
- Un traitement doit monter en charge indépendamment du reste de l’application.
- Plusieurs équipes doivent livrer à des rythmes différents, avec des responsabilités métier bien délimitées.
- Des tâches longues ou irrégulières gagnent à être confiées à des workers et à une file de messages.
- Des applications existantes doivent être intégrées à une solution différente; avec des rythmes de mises à jour différents.
Pour une petite application gérée par une seule équipe, dont les besoins sont homogènes et les déploiements simples, la distribution peut coûter davantage qu’elle n'apporte de plus-values. Dans ce cas, une architecture monolithe modulaire permet souvent de définir des périmètres métier avant d’introduire des communications réseau.
Les bonnes pratiques avec .NET
Définir des périmètres métier cohérents
Regrouper les règles et les données qui évoluent ensemble, puis limiter les échanges entre composants.
Attribuer les responsabilités sur les données
Réserver les écritures à un composant / une application et partager les informations nécessaires par API ou événement.
Choisir les échanges adaptés
Utiliser ASP.NET Core avec HTTP ou gRPC pour une réponse immédiate et la messagerie pour les traitements différés.
Prévoir les défaillances réseau
Configurer les délais, les annulations les *politiques de retry* ; éviter de relancer sans précaution un service non idempotent.
Fiabiliser la publication
Utiliser une Outbox (telle qu'une table dans laquelle une application enregistre les messages qu’elle doit publier), lorsque la persistance avec Entity Framework Core et la publication doivent rester liées.
Observer les parcours
Corréler les journaux, les métriques et les traces avec une solution telle qu'OpenTelemetry.
Sécuriser chaque composant
Authentifier les appelants, vérifier qu'ils possèdent les autorisations nécessaires et les informations secrètes en dehors du code source (en utilisant un Vault, des UserSecrets, etc.).
Faire évoluer les contrats
Documenter les API avec OpenAPI, versionner lorsque c’est nécessaire et vérifier la compatibilité avec les consommateurs.
Dans l'écosystème .NET, ASP.NET Core fournit le nécessaire (Web API, gRPC, HttpClient, etc.) pour implémenter des appels directs. Les Background Services sont adaptés aux workers, Entity Framework Core prend en charge les transactions locales et OpenTelemetry aide à suivre les corrélations dans l'exécution des services. Microsoft Aspire peut faciliter la description, l’exécution locale et l’observation des composants.