Architecture microservices
Introduction
Lorsque toutes les fonctionnalités d’une application sont développées et déployées ensemble, une modification peut conduire à republier l'intégralité de l'application. Pour certaines entreprises, les besoins d’évolution, de disponibilité et de montée en charge finissent par rendre ce fonctionnement contraignant. L’architecture microservices propose de répartir les capacités métier entre plusieurs services autonomes. Cependant, cette autonomie a un coût : l'exécution de services se font au travers du réseau et leur exploitation devient plus exigeante.
Présentation
Une application basée sur des microservices est composée de services qui portent chacun une fonctionnalité métier, exposent un contrat et peuvent être déployés de manière indépendante. Dans une application de vente, on pourrait distinguer un service Catalogue, un service Commandes et un service Paiements. La frontière suit les responsabilités métier : elle ne correspond pas nécessairement à une table, à une classe ou à un contrôleur.
Chaque service maîtrise ses règles et ses données. Par exemple, le service Commandes ne devrait pas lire directement les tables internes du service Paiements. Il obtient les informations nécessaires au travers d'un endpoint ou des événements publiés par ce service. Deux services peuvent partager un même serveur de bases de données, mais chaque service doit gérer ses données sans interférence avec un autre service. D'un autre côté, une base unique où toutes les tables sont librement partagées limite fortement l'autonomie des services.
Les échanges peuvent être synchrones, lorsqu’une réponse est nécessaire immédiatement, ou asynchrones lorsqu’un service publie un message que d’autres traiteront ensuite. Plusieurs services distribués ne forment pas automatiquement une bonne architecture microservices : l’autonomie dépend aussi des contrats, de la propriété des données et de la capacité à livrer chaque service.
À distinguer des Service Orientés Architecture (SOA) : les deux approches organisent le système autour de services et de contrats. Les « microservices » mettent davantage l’accent sur des périmètres métier, l’autonomie des données et des déploiements.
Un exemple simple en C#
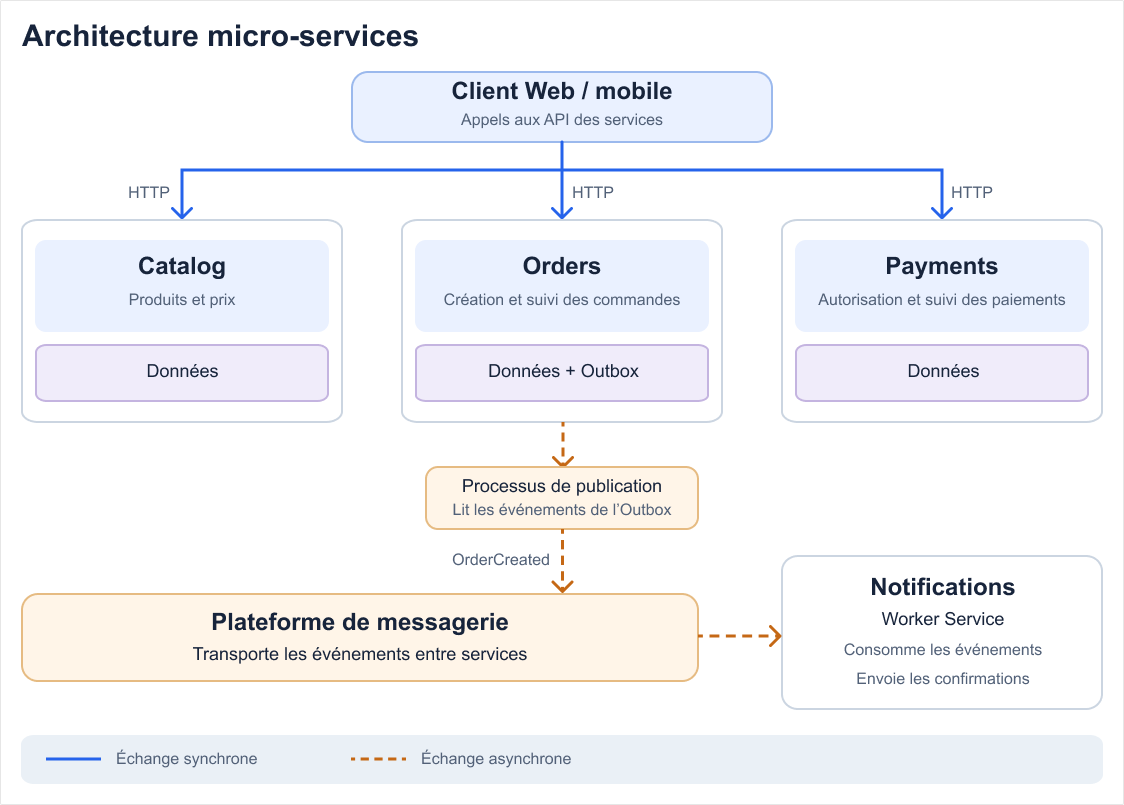
Nous pourrions organiser une application de commerce électronique de la manière suivante :
| Service | Responsabilité | Composants .NET utilisés |
|---|---|---|
Catalog |
Présenter les produits et leurs prix | ASP.NET Core et EF Core |
Orders |
Créer et suivre les commandes | ASP.NET Core et base de données propre |
Payments |
Autoriser et enregistrer les paiements | ASP.NET Core, avec l'intégration d’un prestataire |
Notifications |
Envoyer les confirmations | Worker Service consommant des messages |
Lorsqu’un client valide une commande, Orders peut enregistrer la commande et un événement CommandeCreee dans la même transaction locale grâce au pattern Outbox. Un processus publie ensuite cet événement. Notifications peut l’utiliser pour envoyer un message. Si la publication ou la consommation est répétée après une panne, l’identifiant de l’événement permet au consommateur de gérer les doublons. Le paiement demande une conception spécifique : il ne faut pas présumer qu’une suite d’appels entre services constitue une transaction unique.
Le pattern Outbox (ou boîte d’envoi transactionnelle), consiste à enregistrer les données métier et le message à publier dans une même transaction de base de données. Le message est ensuite envoyé par un traitement en arrière-plan.
En utilisant l'écosystème .NET :
- ASP.NET Core permet d’exposer les API.
- La classe HttpClientFactory permet de configurer les clients HTTP.
- EF Core de gérer les données.
- La classe BackgroundService d’exécuter des traitements exécutés en continu (en arrière plan).
De plus, une plateforme de messagerie peut porter gérer l'envoi et la consommation des événements (en utilisant la classe Channel<T>). Une solution telle qu'OpenTelemetry aide à corréler les traces, métriques et journaux.
Les avantages
Des déploiements indépendants
Un service peut être livré sans republier toute l’application, si ses contrats restent compatibles avec les clients qui l'utilisent.
Une mise à l’échelle ciblée
Les services les plus sollicités peuvent recevoir davantage de ressources.
Des responsabilités métier explicites
Chaque service possède un périmètre défini, explicitant exactement "qui fait quoi".
Une autonomie des équipes
Des équipes peuvent faire évoluer leurs services à leur rythme si leurs dépendances sont maîtrisées.
Une meilleure tolérance aux anomalies
Une défaillance peut rester limitée à un service si les autres services peuvent travailler de manière dégradée.
Les limites
Des échanges plus fragiles
Le réseau ajoute de la latence, des interruptions et des erreurs partielles qu’un appel local ne présente pas de la même façon.
Des données distribuées
Une opération impliquant plusieurs services ne bénéficie généralement pas d’une transaction unique ; la cohérence peut être différée.
Une exploitation plus exigeante
Déploiements, supervision, gestion des secrets et diagnostic des parcours nécessitent davantage d’outillage et de compétences.
Des contrats à faire évoluer
Les producteurs et consommateurs ne changent pas toujours simultanément ; leurs API et messages doivent rester compatibles pendant la transition.
Un risque de découpage excessif
Des services trop petits et très dépendants multiplient les appels et imposent des livraisons coordonnées.
Des coûts supplémentaires
Réseau, messagerie, environnements, observabilité et exploitation ont un coût, même si chaque service contient peu de code.
Quand cette architecture est-elle un choix pertinent ?
Cette architecture devient intéressante lorsque plusieurs fonctionnalités de taille importante ont des rythmes d’évolution distincts, que des équipes peuvent en assumer la responsabilité de bout en bout, et que les gains attendus de déploiement ou de mise à l’échelle indépendante justifient la complexité distribuée. Une charge très variable concentrée sur certaines fonctions ou des exigences de disponibilité différentes peuvent aussi motiver un découpage ciblé.
À l’inverse, pour un produit naissant, une petite équipe ou des frontières métier encore incertaines, commencer par un monolithe modulaire est souvent plus raisonnable. Il permet de stabiliser le domaine et de mesurer les contraintes avant d’extraire un service précis. Le nombre de développeurs ou de requêtes par seconde, pris seul, ne constitue pas un seuil universel imposant les microservices.
Avant de décider, on peut se demander : quelles fonctionnalités doivent réellement être déployées ou dimensionnées séparément ? Quelles données leur appartiennent ? Quelles interactions exigent une réponse immédiate ? L’équipe peut-elle exploiter et diagnostiquer un système distribué ? Si les réponses restent floues, commencer avec moins de services réduit les risques.
Les bonnes pratiques avec .NET
Définir des périmètres métier
Construire les services autour de capacités cohérentes et ajuster leur taille lorsque leurs échanges révèlent un découpage nuisible à la maintenance ou l'évolutivité.
Définir qui gère quelles données
Attribuer des responsabilité de gestion de données à chaque service et exposer les informations nécessaires par API ou événement.
Concevoir des contrats explicites
Documenter les API avec OpenAPI, stabiliser les messages et prévoir le versionnage des services et de leurs contrats.
Choisir le bon mode d’échange
Utiliser les protocoles HTTP / gRPC pour une réponse immédiate et la messagerie pour les traitements différés ou l'envoi d’événements.
Prévoir les défaillances
Configurer des délais d'expiration, des annulations, en évitant les longues chaînes d’appels synchrones.
Sécuriser les accès
Authentifier les consommateur, vérifier leurs autorisations afin de sécuriser les services ainsi que l'accès / mises à jour de données sensibles.
Observer les parcours
Corréler journaux, métriques et traces afin de suivre une opération lorsqu’elle traverse plusieurs services (via un identifiant de corrélation).