Azure Synaspe Analytics : stocker, traiter, intégrer et analyser vos données
Introduction
Dans une entreprise, les données sont souvent réparties entre plusieurs systèmes : applications métier, bases de données, fichiers, services Cloud ou équipements connectés (IoT). Pour analyser l’activité dans son ensemble, il faut rapprocher ces données, harmoniser leur structure et calculer des indicateurs.
Azure Synapse Analytics rassemble plusieurs outils pour construire cette chaîne de traitement. Les résultats peuvent ensuite être exploités dans des rapports et des tableaux de bord, notamment avec Power BI.
Les principaux composants
| Composant | Rôle |
|---|---|
| Pipelines Synapse | Collecter les données et orchestrer les traitements : copies, transformations, exécution de notebooks ou de scripts SQL. |
| Pool SQL serverless | Interroger avec SQL des fichiers conservés dans un stockage Azure, sans provisionner un pool de calcul dédié. |
| Pool SQL dédié | Héberger un entrepôt de données relationnel et exécuter des analyses avec une capacité de calcul provisionnée. |
| Pools Apache Spark | Préparer et transformer de grands volumes de données, notamment à l’aide de notebooks. |
| Synapse Studio | Fournir une interface Web commune pour développer, exécuter et superviser les traitements. |
Les pipelines reposent sur le même moteur d’intégration de données qu’Azure Data Factory. Azure Synapse Analytics réunit ces capacités avec SQL et Spark dans un même environnement de travail.
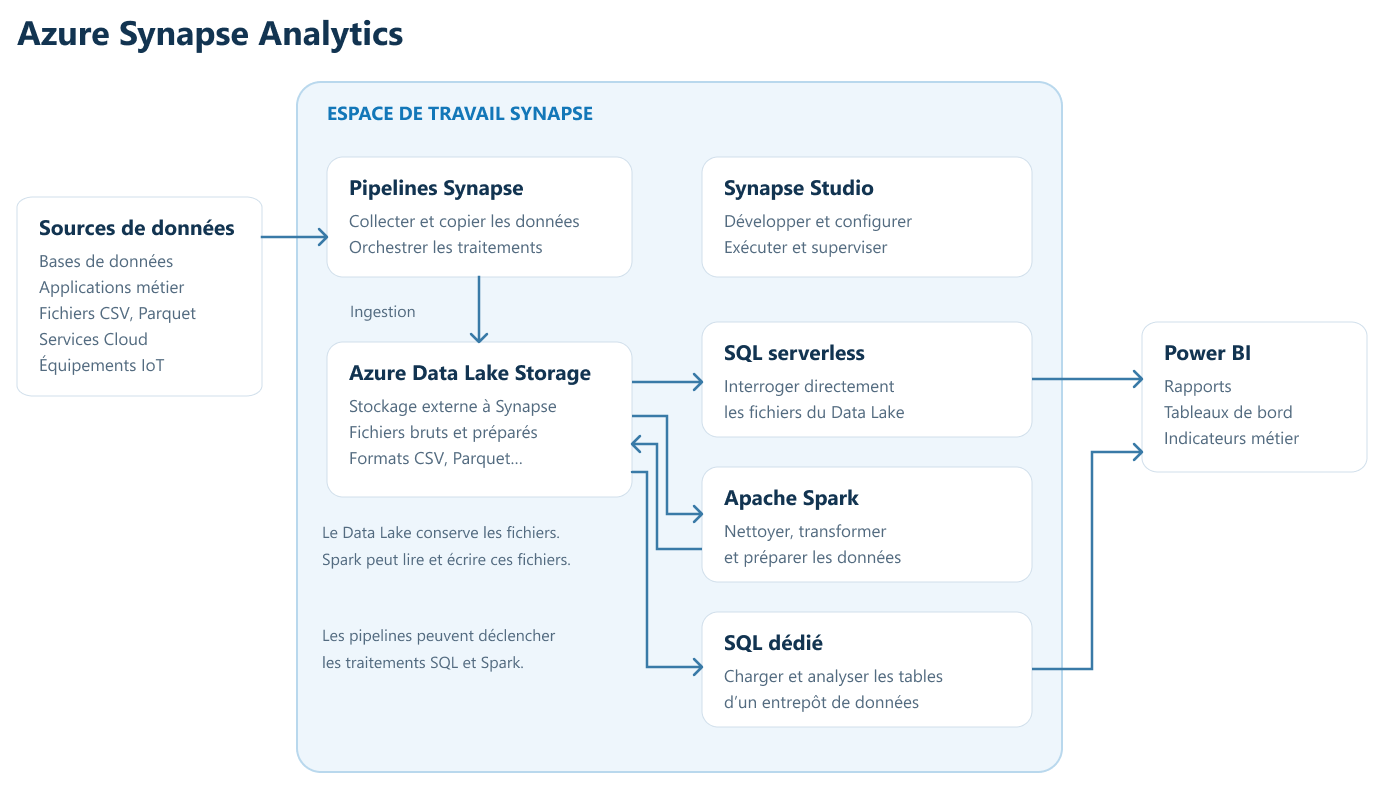
Le schéma ci-dessous présente les principaux composants d’Azure Synapse Analytics et leur rôle dans la collecte, la préparation et l’analyse des données, jusqu’à leur restitution sous forme de rapports et de tableaux de bord dans Power BI. Il s'agit d'un exemple, les composants sont choisis selon les besoins et ne sont pas tous obligatoires :
Deux approches pour analyser les données avec SQL
Deux modes complémentaires sont proposés, et le choix dépend de critères tels que l’emplacement des données, la fréquence des analyses et les performances attendues :
Le pool SQL serverless permet d’interroger directement des fichiers présents dans un Data Lake, par exemple des fichiers CSV ou Apache Parquet. Les données restent dans le stockage externe : ce pool ne possède pas de stockage local pour héberger les tables d’un entrepôt de données. Cette solution convient notamment à l’exploration de données et aux analyses ponctuelles.
Le pool SQL dédié permet de charger les données dans des tables destinées à l’analyse. Il répartit les données et les traitements entre plusieurs ressources de calcul qui travaillent en même temps, afin d’accélérer l’analyse de grands volumes de données. Il répond aux besoins d’un entrepôt de données alimenté et interrogé régulièrement.
Exemple d’utilisation
Prenons une entreprise qui souhaite analyser ses ventes :
- Des pipelines collectent les commandes, les informations clients et les données produits.
- Les données brutes sont déposées dans Azure Data Lake Storage.
- Des traitements Spark nettoient les données et harmonisent les formats.
- Les données préparées sont interrogées directement avec SQL serverless, ou chargées dans un pool SQL dédié.
- Power BI présente le chiffre d’affaires, les ventes par région et l’évolution des commandes.
Il s’agit d’un exemple d’organisation : tous les composants ne sont pas nécessaires dans chaque solution. Un besoin simple peut être couvert par des fichiers et des requêtes SQL, sans traitement Spark.
Sécurité et exploitation
Une solution Azure Synaspe Analytics doit protéger les données et contrôler les accès à plusieurs niveaux : authentification, autorisations, stockage et réseau. Microsoft documente notamment les mécanismes de protection des données, de contrôle d’accès et de sécurité réseau. Les permissions doivent être cohérentes entre l’espace de travail, les moteurs de traitement et les données auxquelles ils accèdent.
Le coût dépend des composants utilisés :
- SQL serverless : volume de données traité par les requêtes.
- SQL dédié : capacité de calcul provisionnée et stockage.
- Spark : ressources de calcul consommées pendant les traitements.
- Pipelines : orchestration, déplacements de données et transformations.
Les services associés, notamment le stockage, ajoutent leurs propres coûts. La conception des traitements et la quantité de données lues influencent donc directement les coûts facturés.
Points de vigilance
Azure Synaspe Analytics demande des compétences en modélisation analytique, en SQL et, selon les besoins en Spark. Les performances ne dépendent pas seulement de la puissance de calcul : l’organisation des fichiers, leur format et la distribution des données jouent également un rôle.
Il faut aussi distinguer une base destinée aux opérations quotidiennes d’une plateforme analytique. Un pool SQL dédié Synapse est conçu pour l’entreposage et l’analyse des données ; il ne constitue pas le choix naturel pour gérer les transactions courantes d’une application métier.
Combiné à Microsoft Fabric
Microsoft propose des parcours de migration depuis plusieurs composants Synapse, notamment les pools SQL dédiés, les traitements Spark et les pipelines. Azure Synaspe Analytics repose sur une approche PaaS, avec des ressources Azure à configurer.
Microsoft Fabric propose une plateforme analytique SaaS, fondée sur des capacités et une expérience davantage intégrée. Pour un nouveau projet, il peut être conseillé de comparer les deux selon les besoins fonctionnels, la sécurité, les coûts et l’environnement existant. Microsoft propose des outils et de la documentation pour migrer d’Azure Synapse Analytics vers Microsoft Fabric. Cette démarche ne constitue toutefois pas, en elle-même, une annonce de fin de service d’Azure Synapse Analytics.